【RAG 混合檢索失敗模式:parent-child chunking 實戰筆記】
RAG 混合檢索要把向量相似度與關鍵字(如 BM25)合排;只靠向量常漏活動碼、SKU 與條款編號。本文用失敗模式說明 parent-child chunking 與混合排序何時仍會答錯、怎樣改。
行銷知識庫助手回覆「Q4 退貨期是 14 天」,週會上預算與客服話術一起跟著改。三天後才發現:正確條款寫的是「指定 SKU 為 7 天,其餘 14 天」,助手只撿到半段。問題通常不在模型「會不會寫」,而在 RAG 混合檢索與切塊粒度:檢索錯,答案錯,決策就錯。
本文用神話對機制的方式,說明為什麼「切小就準」不夠,parent-child chunking 解決什麼、解不了什麼,以及向量加關鍵字的混合排序何時必須上。英文常見寫法是 hybrid retrieval 與 parent-child chunking;中文主詞仍用「RAG 混合檢索」。
資料核對於 2026 年 10 月 18 日公開文件(見文末)。本文屬操作筆記與失敗指紋,非帳號實測報告。
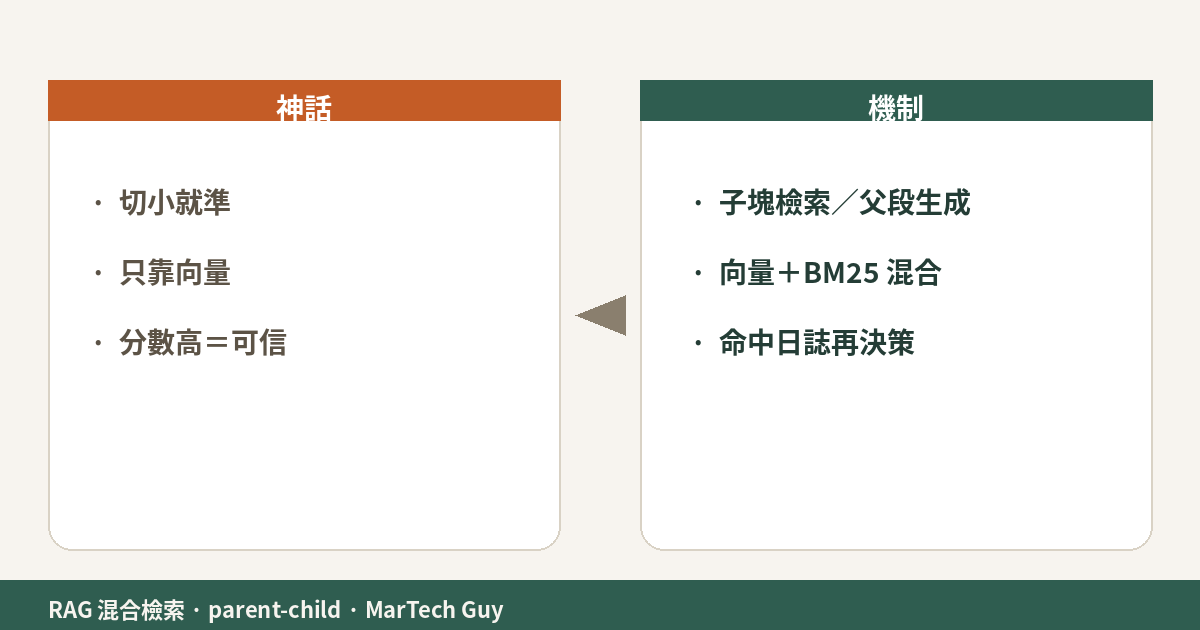
神話:切得越小,檢索就越準
常見預設是:把 FAQ、活動辦法、產品規格拆成短句,embedding 一定更準,助手就少幻覺。短塊確實有利於向量對上「這一句在說什麼」;LangChain 的 ParentDocumentRetriever 說明也寫明,文件太長時 embedding 容易失焦。
另一半卻常被忽略:生成時需要足夠上下文。條款的例外、適用 SKU、生效日,往往寫在鄰近段落。只把命中的短句丟進提示,模型會用漂亮語氣補洞,讀起來像對,決策依據卻缺了一半。
危險在於把「檢索分數好看」直接當成「決策訊號可信」。行銷場景裡,錯的是活動碼、退貨窗、折扣門檻這類可核對字串;分數高但漏字,一樣會把預算與話術帶歪。
機制:檢索粒度與生成粒度可以分開
parent-child chunking(父子切塊)的核心,是把兩種粒度拆開:
- 子塊(child):較短,負責被 embedding、被相似度搜到。
- 父段(parent):較長(整份文件或更大的塊),在命中子塊後還原給模型當上下文。
LangChain ParentDocumentRetriever 的公開說明:先取小塊,再依 parent id 回傳較大文件;parent 可以是原文,也可以是較大的中間塊。MongoDB 與 LangChain 的整合文件同樣描述:對小子塊做向量搜尋,再把對應父文件交給 LLM,並可只為子塊建 embedding、父塊用 doc_id 連結。
LlamaIndex 則用 HierarchicalNodeParser 預設層級(公開範例為 2048/512/128)建樹,葉節點進向量庫;AutoMergingRetriever 在多個子節點同屬一父、超過門檻時,合併回較大父節點再合成答案。
可以這樣記:子塊負責「找得到」,父段負責「講得完整」。它不自動等於「找得到精確 ID」。活動碼 SPRING26-VIP、SKU、條款條號這類字串,向量路徑常因同義改寫而漏;那是下一節混合檢索要補的洞。
RAG chunking 策略:三種失敗樣貌
把切塊選擇對上失敗指紋,通常比背一份通用「最佳 chunk 大小」更踏實。以下為示範情境(非實測帳號數字)。
樣貌一:命中對了半句,決策吃了整段例外
知識庫有一段:「一般商品退貨期為 14 天;特價區 SKU 開頭 CLR- 為 7 天。」固定窗把兩句切開,助手只檢回第一句,客服照 14 天對外承諾。 對策方向: parent-child 或結構感知切塊,讓「一般/例外」同屬一父段;生成時帶父段,不帶裸子句。
樣貌二:語義相近,精確字串沒上榜
同事問「SPRING26-VIP 還能不能疊加運費券」。向量把「春季 VIP 活動說明」的散文段排很前,但含活動碼的表格列因字少、改寫多而落榜。 對策方向: 上 RAG 混合檢索(向量+關鍵字/BM25),讓精確 token 有獨立通道。
樣貌三:父段還原後重複灌水,真正答案被擠掉
同一父文件被多個子塊命中,父段重複送進上下文,模型窗口被同一段政策佔滿,真正相關的另一份「疊加規則」進不來。 對策方向: 父段去重、限制每父只進一次、控制 top_k;AutoMerging 類邏輯也要設合併門檻,避免「合併=整庫灌入」。
這三種樣貌對應不同的 RAG chunking 策略選擇:固定窗適合均勻手冊;父子適合條款與例外綁在一起的政策文;結構感知(依標題/表格)適合規格書。沒有單一策略能同時修好語義漏字與窗口灌水。
parent-child chunking:何時該用、何時先別用
較適合:
- 政策、活動辦法、退貨與免責:例外句與主句必須同屏。
- 長 FAQ:問題短、答案跨段。
- 規格說明:參數表與適用條件分屬鄰近段。
先別急著上:
- 知識庫幾乎是短卡片、一問一答已自洽:父子帶來的 docstore 複雜度可能高於收益。
- 主要卡關是「活動碼/SKU 搜不到」:先補關鍵字或混合排序,單加父子幫不上精確匹配。
- 尚未有檢索日誌:不知道漏在子塊分數、父段缺失,還是生成胡謅;先記 query、命中 id、是否還原父段,再改架構。
公開文件給的數字(例如子塊約 200 字元、父塊約 2000,或 2048/512/128 層級)是相對比例示範,不是全行業標準。要按自己文件的標題密度與表格比例調,並用同一批回歸問題重跑。
RAG 混合檢索:向量加上關鍵字怎麼合
只做向量,常見漏的是:活動碼、訂單前綴、內部短碼、法條編號、精確產品名。只做關鍵字,又容易輸在同義改寫(「退貨」對「退換貨/七天鑑賞」)。RAG 混合檢索的目的,是讓兩條通道都能進入最終上下文。
LlamaIndex 公開的 Reciprocal Rerank Fusion 做法:向量 retriever 與 BM25Retriever 並行,再用 reciprocal rerank(RRF)重排,不必先上額外的重排模型;也可關掉多查詢生成,只融原本的那一條 user query。這就是實務上常說的 hybrid retrieval:dense(向量)加 sparse(關鍵字)再融合。
示範情境(操作步驟,非實測分數):
- 固定一組回歸問題:至少含「純語義」「純 ID/活動碼」「條款例外」三類。
- 分別記:僅向量、僅 BM25、融合後的命中 id 是否含金標段落。
- 調
top_k與融合後截斷;觀察父段去重後,窗口是否還塞得下第二份相關政策。 - 把「必須字面命中」的欄位(活動碼、SKU)在索引前另建關鍵字欄或全文欄,避免只靠 embedding。
混合檢索修的是「找得到哪一段」;parent-child 修的是「找到之後夠不夠完整」。兩者常一起用,但故障要分開驗:先看命中集合,再看還原後的父段,最後才看生成句。
知識庫 RAG:行銷場景裡的決策風險
知識庫 RAG 在行銷堆疊裡,常見落地是:活動辦法、會員權益、產品規格、客服話術稿、內部投放備註。這些文件的共同點是「錯一個字就會變成對外承諾」。
決策鏈可以寫成:
檢索集合錯 → 生成語氣仍自信 → 週會/客服/素材照抄 → 預算或客訴成本落地。
評斷助手能不能用,別只看「回覆好不好讀」。最低限度要能回答:這句話對應哪條父段、父段是否含例外、活動碼是否經關鍵字通道進榜。若助手無法指出來源段落,就不該直接進決策欄。
與站上其他文章的分界:治理清單見行銷 AI 治理五道關;報表代理的來源/證據/覆核見AI 報表代理:上線前先核對來源與證據。本篇只處理檢索與切塊失敗如何把決策訊號帶歪。RAG 評估指標與 LLM-as-judge 的專題,另篇再寫,此處只把「回歸問題+命中日誌」當下一步,不展開評分表。
怎樣按自己的知識庫改
若你正在為行銷或客服知識庫選切塊與檢索:
- 先抽 20~30 條真實會問的問題,標金標段落(含例外句與 ID)。
- 跑僅向量基線,記錄漏掉的是語義題還是 ID 題。
- ID/短碼題占比高,就先上混合檢索(向量+BM25/全文),再考慮父子。
- 例外句常被切開,再上 parent-child 或標題感知切塊,並做父段去重。
- 每次改架構只動一個旋鈕,用同一回歸集對照命中 id。
留給你自己的堆疊一個問題:最近一次「答得很像、決策卻錯了」,問題落在子塊沒命中、父段沒還原,還是關鍵字通道根本沒開?先把那一條問句與金標段落留下來,通常比再換一個 embedding 模型更早定位。
常見問題
什麼是 RAG 混合檢索? 同時使用向量相似度與關鍵字(例如 BM25)取回候選,再以融合排序(如 reciprocal rerank)決定進提示的段落。目的是兼顧同義理解與精確字串。
parent-child chunking 跟一般固定窗有何不同? 固定窗用同一長度切、同一長度檢、同一長度生成。父子則用小子塊檢索、大父段生成,讓「找得到」與「講得完」分開調。
hybrid retrieval 是不是一定要上重排模型? 不一定。公開範例可用 RRF 融合向量與 BM25 分數,先驗證命中集合,再決定要不要加 cross-encoder 重排。
知識庫 RAG 上線前最少要看什麼日誌? query、各通道命中 id、是否還原父段、最終進提示的去重後段落清單。沒有這四樣,很難分辨是切塊問題還是生成胡謅。
相關文章
需要把追蹤與報表口徑一次對齊時,可先做量度自查。訂閱後解鎖完整清單。
資料來源(2026-10-18 核對): LangChain ParentDocumentRetriever;MongoDB Atlas:Parent Document Retrieval with LangChain;LlamaIndex Auto Merging Retriever / HierarchicalNodeParser;LlamaIndex Reciprocal Rerank Fusion Retriever。