【AI 導購的對話變成漏斗數據,報表可以信多少?】
Mixpanel 在 10 月 1 日推出 Agent Intelligence(早期試用,Beta),AI 代理的對話可以直接放進漏斗。以一個示範網店情境,逐項核對身分、對話分組、欄位截斷、成本與錯誤口徑、對照組和私隱,再決定報表能信多少。
數據分析平台 Mixpanel 在 10 月 1 日(美東時間早上 9 時,即香港時間晚上 9 時)公布新產品 Agent Intelligence。按 Mixpanel 公布,AI 代理的每段對話會變成事件,與產品內其他行為共用同一個用戶身分,可以直接放進漏斗、分群和留存報表。產品目前屬早期試用(Beta),按官方文件只開放給有限數量的客戶。
放到網店的情境,網站上的 AI 導購或客服 bot,從此可以和「加入購物車」「下單」排在同一條漏斗上。圖表一出,「AI 導購帶來轉換」看起來就有了證據。
這張圖表能信多少,要看數據怎樣進來:對話是否對得上下單的那個人,一段對話有沒有被拆開或重複計算,欄位會不會被截斷,成本、時長和錯誤按甚麼口徑加總,以及有沒有對照組。本文以 Mixpanel 的官方文件作例子,逐項拆解要核對甚麼,並對照廠商中立的 OpenTelemetry 規範和 Google Analytics(GA)的自訂事件規則。這些核對適用於任何把 AI 代理追蹤數據送進分析工具的做法。
(本文的功能描述以 Mixpanel 2026 年 10 月 1 日新聞稿、產品頁及官方文件為準,文件於 2026 年 10 月 3 日查閱。Mixpanel 只作例子,本文並非推薦任何產品,亦未經實際操作測試。所有示範數據均不代表任何品牌。)
一、Mixpanel 公布了甚麼:對話變成事件,仍在早期試用
新聞稿的內容(2026 年 10 月 1 日)
按 Mixpanel 新聞稿,Agent Intelligence 有四個重點:
- 代理的活動原本是零散的片段,Mixpanel 會把片段拼回所屬的對話。團隊可以逐個回合打開對話,下面列出每次工具調用和結果。
- 成本、延遲和錯誤指標預先載入,不用先建 dashboard。
- 代理對話變成事件,與團隊追蹤的其他行為使用同一個用戶身分,可在漏斗、Session Replay、分群和留存報表中使用。
- 實驗和 feature flag 可以比較不同的 prompt、工具設定或模型,看哪一個真正推動指標。
新聞稿引述 Mixpanel 技術總監,指產品是為回答「代理在推動用戶走完漏斗,還是在阻礙他們」「換了模型,體驗有沒有改善」這類問題而建,Mixpanel 亦用它評估自家的 Mixpanel Agent。同場公布的還有能力更強的 Mixpanel Agent、免寫程式的實驗功能、Context Engine 和 AI 數據管治。
官方文件的內容(2026 年 10 月 3 日查閱)
文件交代了數據怎樣進來,這部分與本文的核對最相關:
- 代理要用 OpenTelemetry 的 GenAI 語義規範(
gen_ai.*,v1.41 或以後)埋點。追蹤數據送進既有的 Mixpanel 專案,不用安裝新工具。 - 每個 span 變成一個 Mixpanel 事件。
- 文件把數據分成三層。對話(conversation)是用戶的整段對話,由一個或多個 trace 組成;回合(turn)是對話中的一問一答;span 是代理為了回應而做的每一件工作,例如一次 LLM 調用,可以順序執行,也可以並行。
- 除預設端點外,另有 EU 和印度的數據駐留端點。
- 文件頂部標示 Beta,只開放給有限數量的客戶,需要申請。產品頁上「按主題和情緒分組對話」一項標示為 Coming Soon。
OpenTelemetry 在這裡的角色
OpenTelemetry 是開源、廠商中立的追蹤標準。Mixpanel 讀取的 gen_ai.conversation.id、gen_ai.request.model 等屬性,定義在 OpenTelemetry 的 GenAI 語義規範內,並非 Mixpanel 自創的欄位。按 OpenTelemetry 的屬性登記頁,gen_ai.conversation.id 的狀態是 Development(開發中),日後仍可能修改。
這一點有兩個含意。第一,埋點按公開規範做,日後換工具時可以沿用大部分工作。第二,規範仍在開發,屬性名稱和規則可能變動,埋點要預留更新的空間。
廠方說法要分清
「全球產品智能領導者」「超過 29,000 間公司使用」都是 Mixpanel 的自述。新聞稿和產品頁引述的客戶評語(Sprout Social、Scribe)屬客戶說法。新聞稿沒有公布任何「AI 代理帶動轉換」的基準數據,產品能量度代理,不等於已證明代理帶來回報。
取捨: 早期試用代表可以較早接觸功能,代價是功能和文件都可能改動,本文所有描述以查閱當日為準。目前未見公開資料說明 Beta 結束日期、香港或亞太地區的供應情況,以及中文介面。
二、網店情境:AI 導購對話放進購買漏斗(示範數據)
先設定一個貫穿全文的示範情境。
一間網店在產品頁加了 AI 導購。一位顧客問「TS-01 有沒有 M 碼」,代理查詢庫存,再檢查優惠碼 SUMMER50 是否有效,然後回覆顧客。顧客把 TS-01 加入購物車,最後下單,訂單編號 ORD-99881,金額 HK$450。(示範情境)
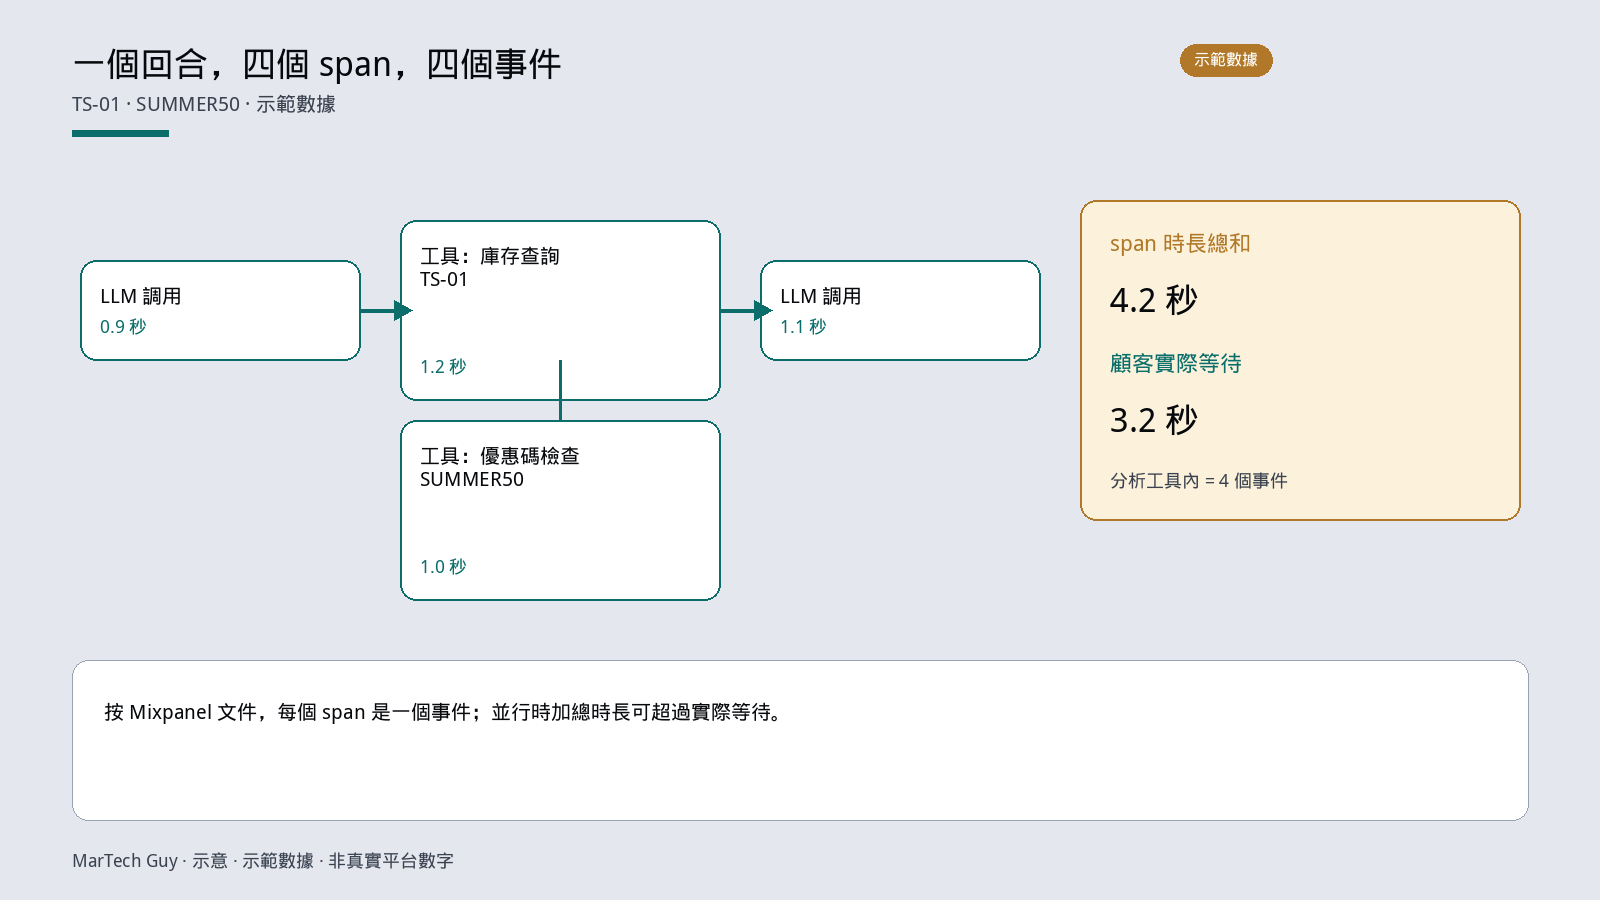
這一個回合背後,代理做了四件工作,即四個 span:
| span | 工作內容 | 時長 |
|---|---|---|
| LLM 調用 | 理解問題「TS-01 有沒有 M 碼」 | 0.9 秒 |
| 工具:庫存查詢 | TS-01 M 碼有貨 | 1.2 秒 |
| 工具:優惠碼檢查 | SUMMER50 有效 | 1.0 秒 |
| LLM 調用 | 生成回覆 | 1.1 秒 |
(示範數據)
按 Mixpanel 文件,每個 span 都會變成一個事件,所以這一個回合在分析工具裡是四個事件。
文件建議的漏斗
文件提出的問題是「代理有沒有帶動轉換」,方法是建一條漏斗:第一步是代理回合,第二步是轉換事件,再按 gen_ai.agent.name 細分比較不同代理,或按 gen_ai.request.model 看換模型後轉換率有沒有變化。文件亦建議用留存報表,比較用過代理和從未用過代理的用戶。
套用到示範網店,一星期的數字可能是這樣:
| 群組 | 第一步 | 加入購物車 | 下單 | 整體轉換率 |
|---|---|---|---|---|
| 曾與 AI 導購完成一個回合 | 2,000 人 | 600 人(30%) | 240 人(40%) | 12% |
| 從未使用 AI 導購的訪客 | 20,000 人 | 2,000 人(10%) | 800 人(40%) | 4% |
(示範數據,不代表任何品牌)
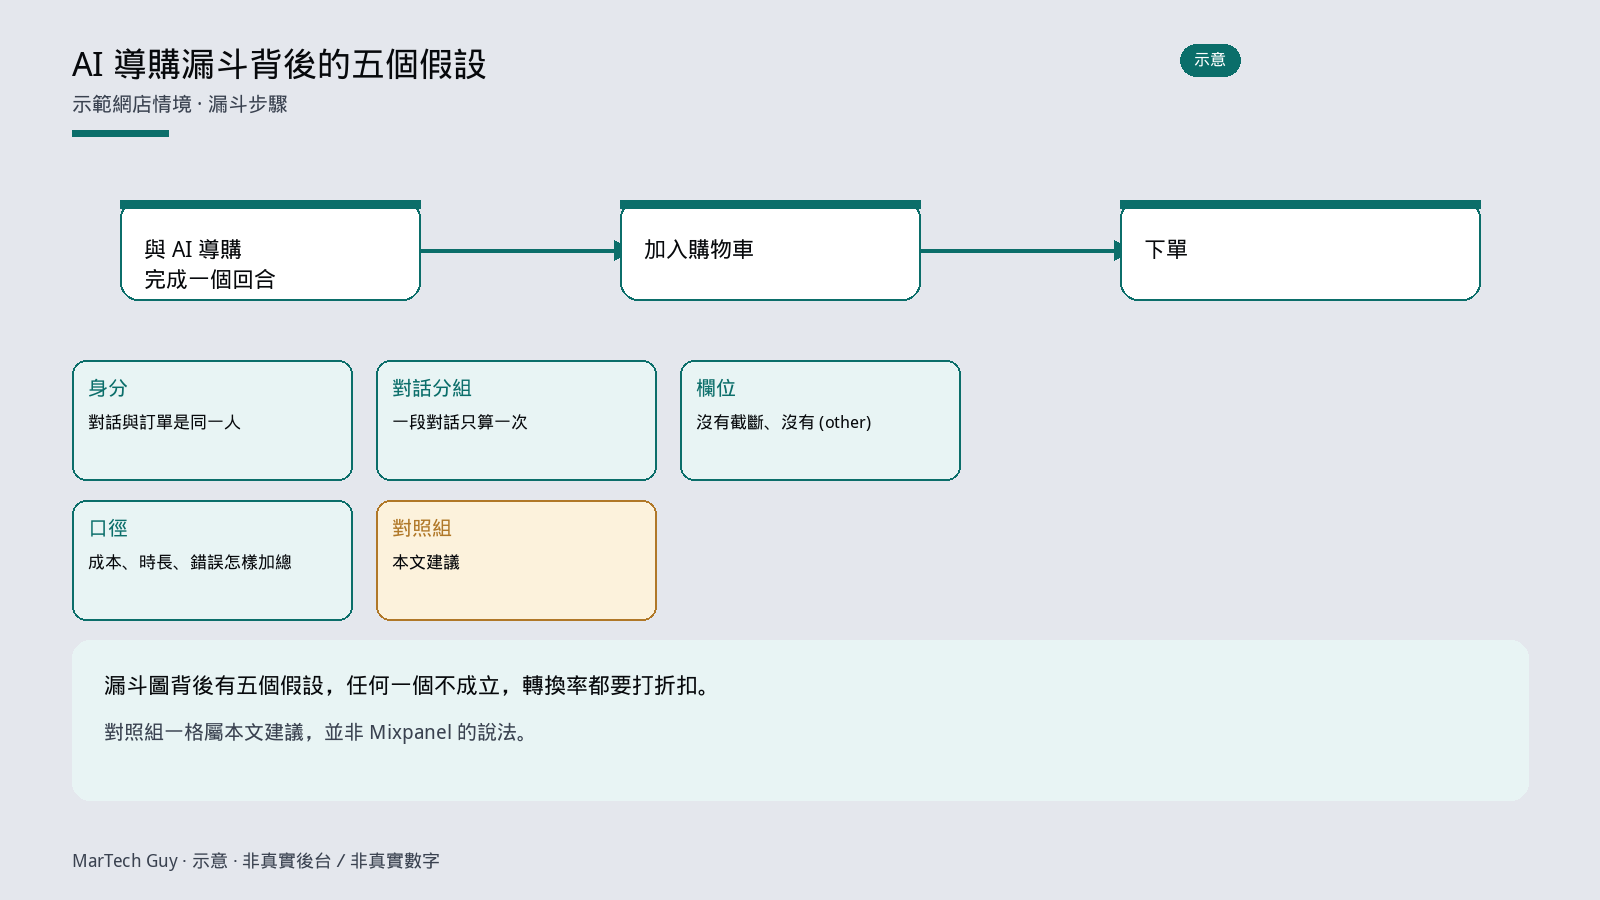
12% 對 4%,看起來是三倍。這就是最容易下錯結論的地方。
這張表成立,背後有幾個假設
- 240 個下單的人,和 2,000 個用過導購的人,在系統裡確實是同一批人(第三節)。
- 「完成一個回合」數的是真實的對話和回合,沒有被拆開或重複計算(第四節)。
- 用來細分的欄位完整,沒有被截斷或歸入「其他」(第五節)。
- 旁邊的成本、時長和錯誤數字,口徑和團隊理解的一樣(第六節)。
- 兩組人本來的購買意向相若(第七節)。
任何一個假設不成立,12% 和三倍都要打折扣。
取捨: 漏斗快、直觀,適合每週追蹤走勢。它能回答「誰走完了」,回答不了「為甚麼走完」。
三、對話與訂單是同一個人嗎?user.id 與訪客合併
按文件: Mixpanel 要求每個 span 都帶 user.id 屬性,值要與 Mixpanel 裡的 distinct_id 相同,系統會把它設為事件的 distinct_id。沒有 user.id 的 span 會被丟棄。文件建議用 OpenTelemetry 的 baggage 設定 user.id,讓它自動傳到子 span;若 tracer 不把 baggage 寫進屬性,就要在 span processor 內設定。
Mixpanel 的身分管理文件(Simplified ID Merge)則說明網站一邊怎樣運作:未登入的訪客用 $device_id 識別,登入後加上 $user_id;同一個事件同時帶兩者時,系統會把兩個 ID 合併成同一個用戶。由伺服器發送事件時,文件建議設定 $device_id 和 $user_id,讓系統推算 distinct_id。文件亦提到,ID 對應最長可能要 24 小時才傳遍整個系統,期間跨越登入前後的即時漏斗,可能把已轉換的人顯示為流失。
為甚麼會對不上
按文件,span 經 OpenTelemetry 直接送往 Mixpanel 的匯入端點,與網站上的瀏覽器 SDK 是兩條路。瀏覽器 SDK 產生的 $device_id,一般不會自動出現在 span 上。常見的錯位有三種:
user.id填了聊天系統自己的訪客編號或 session 編號,與網站的distinct_id不同。結果對話算在一個人身上,訂單算在另一個人身上,漏斗第一步的人永遠走不到第二步。- 顧客未登入就開始對話,系統沒有可用的 ID,於是 span 沒有
user.id,整段對話被丟棄,報表上看不出缺了甚麼。 - 共用裝置。身分管理文件建議登出時重設,否則下一位使用者的行為可能併入上一位。
至於未登入訪客的對話應該怎樣填 user.id、能否在登入後與訂單合併,Agent Intelligence 文件沒有說明。這一點要自行測試,或向廠方確認。
檢查方法:
- 對數: 同一日,代理系統自己的日誌記錄了多少段對話,分析工具收到多少段。差距就是被丟棄或錯配的部分。
- 抽一條完整旅程: 以示範的 TS-01 對話和 ORD-99881 訂單為例,在單一用戶的活動記錄中確認,對話事件和下單事件出現在同一個用戶下。
- 測試訪客旅程: 未登入時開始對話,之後登入結帳,看對話和訂單是否歸到同一人。
- 避開最近 24 小時: 跨越登入前後的漏斗,日期範圍不要包括最近一天。
- 共用裝置: 登出再由另一個帳號登入,確認新對話沒有掛到上一位顧客。
示範例子(示範數據):
| 項目 | 數量 |
|---|---|
| 代理系統日誌記錄的對話 | 2,000 |
| 分析工具收到的對話 | 1,640 |
| 差距 | 360(18%) |
| 其中:未登入訪客的對話 | 310 |
| 其中:已登入顧客的對話 | 50 |
差距集中在未登入訪客,問題多數出在訪客階段沒有可用的 user.id。已登入的 50 段,則要追查 baggage 有沒有傳到每個子 span。
若網店同時把 AI 導購的關鍵動作送進 GA,原則相同:對話事件要帶上與下單事件一致的用戶識別方式,否則兩邊的漏斗都會斷開。
取捨: 只送已登入顧客的對話最乾淨,但會漏掉未登入階段的所有對話,漏斗只反映回頭客。要涵蓋訪客,就要投入工程時間處理匿名 ID 與登入後的合併,並接受最長 24 小時的延遲。
四、一段對話算成幾段?conversation.id、span 與重複事件
身分對上之後,下一個問題是數量。同一段對話,在報表上可能變成好幾段,也可能被計算兩次。
按文件與規範:
- Mixpanel 文件的疑難排解寫明:若每個回合都變成一段獨立對話,原因是
gen_ai.conversation.id沒有設定,或沒有傳到子 span。 - OpenTelemetry 的 GenAI span 規範把
gen_ai.conversation.id列為有條件必填:只有在被埋點的工具本身有對話 ID,或應用程式經 OpenTelemetry context 提供時才填。規範同時寫明,沒有對話 ID 時不應自行補上,例如新產生的 UUID、trace ID 或請求內容的雜湊值,都不應用作後備值。自行管理對話紀錄的應用程式,可以用 span processor 等方式把對話 ID 加到 span 上。
數字會被放大的三個位置
- 沒有對話 ID: 每個回合各自算一段對話。「每位用戶平均對話數」因此虛高,「每段對話平均回合數」則卡在 1。
- 把 span 數當成回合數: 第二節的示範回合有四個 span,即四個事件。報「AI 導購被使用了多少次」時直接數事件,數字會是回合數的好幾倍。
- 新舊事件重複: 網店早前可能已從前端送出自訂事件,例如每次打開導購就記一個
ai_chat_open。接入 span 之後,同一個動作有兩套事件。新聞稿引述 Sprout Social 的產品管理高級總監,提到他們在使用 Agent Intelligence 之前,正是把每次代理互動記成一個獨立的自訂事件。GA 的說明文件亦提醒,在 GA 介面複製或修改事件的同時,若開發人員也在網站程式碼建立同一個自訂事件,可能重複計算。
檢查方法:
- 看「每段對話平均回合數」。若長期是 1.0,先查對話 ID。
- 確認對話 ID 來自導購系統真實的對話紀錄(例如聊天 session),並傳到每個子 span,而非臨時用 trace ID 代替。
- 報表寫明單位:對話、回合、span 三者分開。漏斗第一步要選定一種,並在報表標題註明。
- 列出所有與導購有關的事件,新舊兩套只保留一套作漏斗步驟,另一套停用,或改名以示區別。
示範例子(示範數據,同一星期):
| 指標 | 對話 ID 未傳遞 | 修正後 |
|---|---|---|
| 回合數 | 5,200 | 5,200 |
| 對話數 | 5,200 | 1,300 |
| 每段對話平均回合數 | 1.0 | 4.0 |
| span 事件數(每回合平均 4 個) | 20,800 | 20,800 |
回合和 span 的數量不變,對話數由 5,200 變成 1,300。若「對話數」曾經放進給管理層的報告,修正後會看似大跌四分之三,其實只是口徑改正。修正前後的數字不要放在同一條趨勢線上比較。
取捨: 遵守規範、不自行補 ID,部分對話會暫時無法分組,報表看起來不夠完整。用 trace ID 硬補,表面整齊,但每個 trace 都被當成一段對話,錯誤藏得更深。
五、事件名稱與參數:欄位會被截斷,還是被歸入 (other)?
細分是漏斗最有用的部分:按頁面、按產品、按 prompt 版本看轉換。前提是用來細分的欄位完整可用。
按 Mixpanel 文件:
- Mixpanel 不認識的屬性,會原名保留為自訂屬性。文件建議自訂屬性使用穩定、小寫、以點分隔的命名,因為整個團隊都會用它篩選。
- Agent Intelligence 的事件沿用 Mixpanel 一般事件的規則:字串屬性最多 255 bytes,超出部分截斷;每個 span 的未壓縮 JSON 要少於 1MB,否則整個 span 無法匯入,會被丟棄。
- 若 span 到達了但屬性是空的,文件指出多數是 tracer 用了 Mixpanel 不讀取的命名空間,要把原始屬性名稱與支援的規範對照。
按 GA 自訂事件說明:
- 事件名稱區分大小寫,要以字母開頭,不能用保留名稱,長度要少於 40 個字元。
- 每個事件最多 25 個參數。
- 參數要建立成自訂維度或指標,才會在報表中顯示。
- 可能值超過 500 個的維度屬高基數維度,報表可能把數值歸入「(other)」一列,或觸發抽樣。
這對網店的意思
255 bytes 對英文很寬鬆,對中文則不然。中文字在 UTF-8 編碼下一般佔 3 bytes,255 bytes 大約只容納 85 個中文字。長的中文產品名稱、顧客問題或代理回覆,若以字串屬性存放,後半段可能被截斷。
GA 一邊的風險在基數。若把對話 ID 或顧客原句當成 GA 參數,再建成自訂維度,可能值很快超過 500 個,報表會出現大量「(other)」。
示範屬性規劃(示範內容):
| 屬性 | 示範值 | 用途 | 風險 |
|---|---|---|---|
surface |
product_page |
對話在哪類頁面開始 | 低 |
sku |
TS-01 |
對話涉及的產品 | 產品多時基數高,送進 GA 要留意 |
coupon.suggested |
SUMMER50 |
代理有沒有提示優惠碼 | 低 |
prompt.version |
2026-09-28 |
比較不同 prompt 版本 | 低 |
product.title_zh |
完整中文產品名稱 | 顯示用 | 超過約 85 個中文字會被截斷 |
檢查方法:
- 列出所有自訂屬性,統一命名,寫進團隊的事件字典。
- 抽查長文字欄位,對比原文和分析工具中的值,確認有沒有被截斷。
- 檢查有沒有屬性長期是空值,再對照規範的屬性名稱。
- 送進 GA 的事件,名稱少於 40 個字元,參數不超過 25 個;對話 ID 這類高基數值不要建成自訂維度。
取捨: 屬性越多,可以細分的角度越多,但事件字典更難維護,送進 GA 時亦更易碰上參數和基數上限。起步時可以只送頁面、產品、優惠碼和 prompt 版本這幾項,有實際問題要回答時再加。
六、成本、時長與錯誤:加總口徑決定報表的意思
Agent Intelligence 的賣點之一,是成本、延遲和錯誤指標開箱即用。這些數字怎樣計出來,文件寫得很清楚,但與一般人的直覺不一定相同。
成本:估算價不等於帳單
按 Mixpanel 文件,$mp_ai_cost_usd 是每次模型調用的美元成本估算,按模型名稱(gen_ai.request.model)和 token 數,套用 Mixpanel 維護的價目表計算,以每 100 萬 token 定價,cache token 另計。幾點要留意:
- 每個 span 按其時間戳當時的價格計算,Mixpanel 表示跨越價格變動的報表因此仍然準確。
- 價目表更新後,下次查詢時會套用到全部歷史數據。換言之,同一份過往的成本報表,日後重新查詢,數字可能改變。
- 沒有公開價格的模型,成本顯示為 $0。模型名稱必須完全相符。
- 這些是牌價估算,不會與供應商帳單完全一致;議價、折扣和 token 以外的收費都不包括在內。
時長:加總不等於顧客等待時間
對話層級的 duration 是所有 span 時長的總和。文件註明,若 span 並行執行,這個數字可能超過用戶實際等待的時間。
以第二節的示範回合為例,四個 span 加起來是 4.2 秒。若庫存查詢和優惠碼檢查同時進行,顧客實際等待的是 0.9 + 1.2 + 1.1 = 3.2 秒。報表寫 4.2 秒,比實際多了 1 秒。
錯誤:一個 span 出錯,整段對話就算出錯
is_error 只要 trace 或對話中任何一個 span 出錯,就是 true。代理重試後成功回答,甚至顧客最後下單,對話仍會被標為錯誤。
示範例子(示範數據,一個月):
| 模型名稱 | 調用次數 | 估算成本 |
|---|---|---|
| model-a | 1,200 | US$18.40 |
| model-a-ft(自訂名稱,價目表沒有) | 300 | US$0.00 |
| 分析工具合計 | 1,500 | US$18.40 |
| 供應商帳單 | 不適用 | US$26.10 |
| 差距 | 不適用 | US$7.70 |
ORD-99881 的那段對話,庫存查詢第一次逾時,重試後成功,顧客最後下單 HK$450。這段對話的 is_error 是 true。(示範數據)
檢查方法:
- 成本報表按
gen_ai.request.model細分,找出 $0 的列。 - 每月把估算成本與供應商帳單對數,並保存當月報表的快照(本文建議)。
- 報表上的
duration註明是「處理時間總和」,不要寫成「顧客等待時間」。若要量度等待時間,另用回合開始至回覆送出的時間。 - 把出錯的對話分成兩類:最後成功回答或成交的,以及真正失敗的。只看
is_error比率會高估失敗。
取捨: 估算成本可以按模型、按對話即時細分,帳單做不到;帳單準確,卻只有月結總數。兩者並用:日常用估算看走勢,涉及回報計算時以帳單為準。
七、漏斗顯示的是關連:成效要靠對照組
第二節的 12% 對 4%,即使身分、分組、欄位和成本全部核對無誤,仍然只是關連。
按文件: Mixpanel 建議用漏斗看代理是否帶動轉換,用留存報表比較用過與未用過代理的用戶。文件亦提到,可以用 feature flag 和實驗測試模型、prompt、工具和介面;因為代理指標也是事件,成本和錯誤率可以像其他指標一樣作為實驗指標。
本文建議(並非 Mixpanel 的說法): 主動打開 AI 導購的顧客,本來就可能較有購買意向。拿他們和「從未使用的訪客」比較,差距有一部分來自人本身。要量度導購帶來的改變,可以保留一個對照組,讓一小部分訪客看不到 AI 導購,再比較兩組的整體下單率。
示範例子(示範數據):
| 組別 | 訪客比例 | 整體下單率 |
|---|---|---|
| 顯示 AI 導購 | 90% | 4.6% |
| 對照組(不顯示) | 10% | 4.2% |
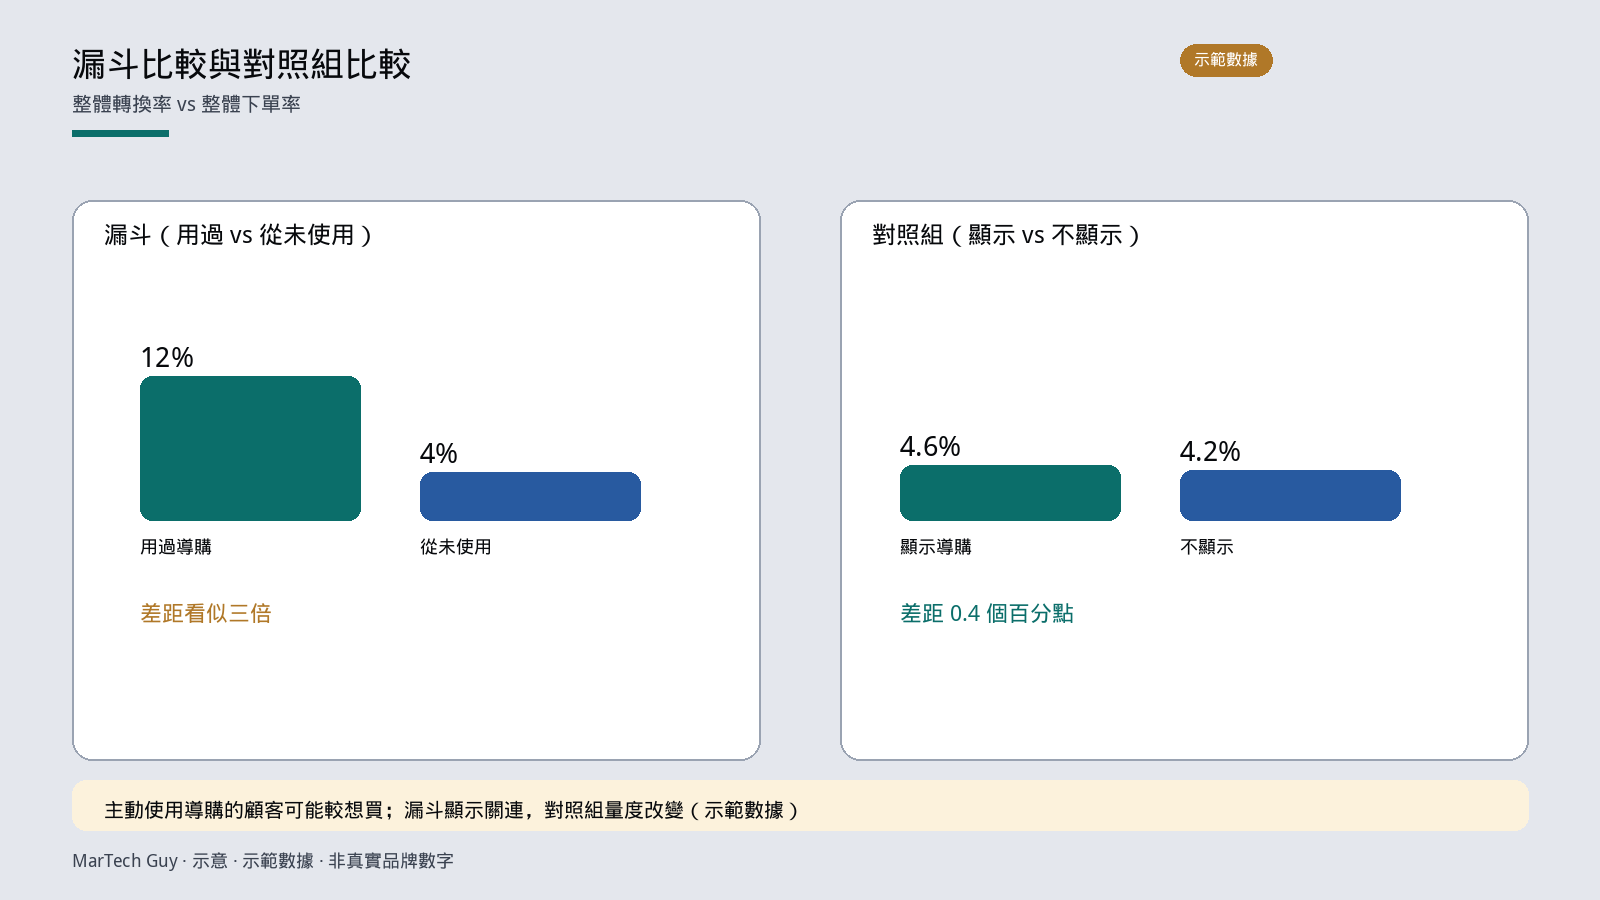
按訪客分組比較,差距是 0.4 個百分點,遠小於漏斗上的 12% 對 4%。
對照組的設計和取捨,在10 月 2 日談 AI 決定電郵內容的文章已有說明,這裡不再重複。
取捨: 對照組會讓一部分訪客用不到導購,短期可能少了一些訂單。換來的是一個可以向管理層交代的數字。
八、私隱、回填與數據量,以及完整清單
最後一組核對,是哪些數據永遠不會到達報表。
私隱:遮蔽不可逆,名單有範圍
按 Mixpanel 文件,系統在匯入時、儲存之前掃描 AI span 屬性,把符合常見個人資料格式的內容換成 [REDACTED:] 佔位符,原值不會寫入,遮蔽亦無法還原。文件列出的類型包括電郵地址、美國社會安全號碼、信用卡號碼、電話號碼、API 金鑰(OpenAI、Slack、GitHub、AWS)、Bearer token 和 IPv4 地址。有內容被遮蔽的事件會帶 $mp_ai_pii_redacted = true。
兩點與網店直接相關。第一,這份名單沒有列出香港身分證號碼或送貨地址,不能假設這些內容會被自動遮蔽。第二,遮蔽不可逆,若顧客在對話中提供訂單電郵,對話紀錄中就只剩佔位符,事後無法憑此追查。
文件亦指出,對話內容、代理回覆和工具調用都是選填屬性,受監管行業通常不送;不送的話,仍然有成本、token、延遲、錯誤、模型、工具使用、對話結構和所有自訂屬性。多數 OpenTelemetry GenAI 埋點預設不擷取 prompt 和回覆文字。若想保留可讀的對話紀錄但先行清理,文件建議在自己的 OpenTelemetry Collector 用 redaction processor 處理,並提醒不要刪掉 user.id。
回填、數據量與抽樣
- 按文件,目前不支援回填過往對話。上線之前沒有可比數據,上線日就是基準的起點(本文建議把上線日寫進報表註腳)。
- 按 Mixpanel 的常見問題,使用 Agent Intelligence 不另收費,但送出的事件計入事件用量。每個 span 都是一個事件,第二節的示範回合就是四個事件。
- 文件建議只送值得調查的工作(模型調用、工具調用、檢索步驟),高流量、低變化的代理可以抽樣,抽樣要以整個 trace 為單位,避免在 span 層級抽樣。
目前的限制
- Agent Intelligence 仍是早期試用(Beta),功能和文件可能改動,以官方最新版本為準。
- 功能描述來自 Mixpanel 的新聞稿、產品頁和文件,屬廠方資料,本文未經實際操作測試。
- 未有公開資料說明:Beta 結束日期、香港或亞太地區的供應情況、中文介面,以及 AI 代理帶動轉換的基準數據。
- GA 或其他分析工具是否有同類功能,本文沒有查證。
- OpenTelemetry 的
gen_ai.conversation.id仍屬開發中狀態。
上線前核對清單(摘要)
- 身分:每個 span 都有
user.id,值與下單事件的distinct_id一致;代理日誌與分析工具的對話數已對數 - 訪客:未登入開始、登入後結帳的旅程已測試;跨登入的漏斗避開最近 24 小時
- 對話分組:每段對話平均回合數不是長期 1.0;對話 ID 來自真實對話紀錄
- 重複:新舊導購事件只保留一套作漏斗步驟;報表註明單位是對話、回合還是 span
- 欄位:自訂屬性命名統一;長中文欄位已檢查截斷;送進 GA 的參數避開高基數
- 成本:按模型細分找出 $0;每月與供應商帳單對數(本文建議)
- 時長與錯誤:不把加總時長當成等待時間;出錯對話已分出最終成功的部分
- 對照組:保留一組看不到 AI 導購的訪客(本文建議)
- 私隱與數據量:決定送不送對話內容;確認名單外的個人資料另行處理;上線日記為基準起點;以整個 trace 抽樣
訂閱後可解鎖 GA 量度自查清單,逐項檢查來源歸因、事件訊號與訂單對帳。
免費 Google Analytics(GA)量度自查清單
約 15 分鐘,逐項檢查來源歸因、事件訊號、成交訊號、事件命名與訂單對帳。
常見問題
Agent Intelligence 現在可以使用嗎?
按 Mixpanel 公布,產品屬早期試用(Beta),官方文件註明只開放給有限數量的客戶,需要申請。
漏斗上用過 AI 導購的人轉換率較高,是否代表導購有效?
不一定。主動使用導購的顧客可能本來就較想買。漏斗顯示的是關連,要知道導購帶來多少改變,需要對照組。
網店用的是 GA,這些核對還適用嗎?
適用。身分一致、對話分組、避免重複事件、欄位長度和基數、成本口徑、對照組,這些問題與工具無關。本文引用的 GA 規則只涉及自訂事件的命名、參數和基數上限;GA 是否有同類的 AI 代理分析功能,本文沒有查證。
要額外付費嗎?
按 Mixpanel 的常見問題,使用 Agent Intelligence 不另收費,但代理事件計入事件用量。
對話內容一定要送進分析工具嗎?
不用。按文件,對話內容、回覆和工具調用都是選填;不送仍有成本、延遲、錯誤和對話結構等數據。
可以補回上線前的對話嗎?
按文件,目前不支援回填,上線日就是可比數據的起點。
一句總結
AI 導購的漏斗圖很快就能畫出來,但數字要先過幾關:對話對得上下單的人、一段對話只算一次、欄位沒有被截斷、成本和錯誤的口徑寫清楚,再用對照組量度實際改變,這張圖才能用來做決定。